DeepSeek火了,游戏服主自建RAG知识库要多大显存才够?
开服三年,玩家群里的问题越来越像客服工单:卡在登录界面、充值不到账、某个MOD和插件冲突、封号申诉流程怎么走。过去靠三五个管理员轮班复制粘贴答案,现在玩家用上了AI,直接在群里@机器人问。想自建一套RAG知识库——把FAQ、活动规则、后台工单记录喂给模型,让它按文档回答——第一个问题就卡住:要买多大显存的机器?和直接买SaaS比,到底谁便宜?这篇按游戏私服/联机服主的真实场景把账拆开算。
先算显存:7B、14B还是直接上API
RAG的显存开销分两块:向量检索和生成模型。检索侧(Embedding+BGE这类模型)很轻,1~2GB显存足够撑几百到几千条文档;真正吃显存的是生成模型。通用经验量级:
- 7B模型,INT4量化约5~6GB显存可跑,FP16约14~16GB;
- 14B模型,INT4约9~10GB,FP16约28GB;
- 32B模型,INT4约18~20GB,FP16基本要双卡;
- 并发不是线性叠加,但首字延迟和并发数强相关。10人同时提问,7B INT4在单张16GB卡上通常还能扛住,30人以上就开始排队。
对游戏服主来说,知识库主要是FAQ、开服公告、充值规则、封禁申诉模板,语义不复杂,7B~14B的指令微调模型加一份好文档,回答质量已经够用。真正要警惕的是文档切分太碎、召回不准,导致模型胡编——这属于工程问题,不是加显存能解决的。判断标准很简单:先用一台能跑7B INT4的机器做两周试点,统计玩家提问的命中率和人工接管率,再决定是否升级到14B。
成本账:云GPU、物理机、SaaS三本账
方案一:公有云GPU按量或包月。一张16GB级别的推理卡,包月通常在数百到一两千元区间,24GB卡更高;按量计费适合夜间低峰,但24小时在线的客服机器人包月更稳。云GPU的好处是弹性、免运维,坏处是长期跑成本高,且数据和模型权重放在别人机器上,玩家手机号、充值记录这类信息要过一遍合规评估。
方案二:自购或租用GPU物理机。以入门推理卡(如1050 Ti、1080、WX 7100这类)为例,租用价可以压到一两百到七八百元每月,比云GPU包月便宜一个量级。但要注意:这些卡跑7B INT4可以,跑14B FP16就吃力;显存4GB的老卡只能做Embedding或小模型实验。私服团队通常不需要训练,只做推理,所以「够用就好」是核心原则。带宽也要算进去:知识库检索和模型推理都在内网完成,对外只需要一个Web入口,10M带宽撑几十个并发提问一般够用,但如果要做玩家上传截图、语音问答,带宽就得往上加。
方案三:SaaS知识库。按坐席或按调用量计费,小团队月费常见在几十到几百元区间,看似最便宜。但隐性成本在于:文档要上传到第三方、回答风格难定制、和游戏后台工单系统打通通常要额外付费或走API。玩家问「我昨晚充的648为什么没到账」,SaaS机器人答不了,还是得人工查库。真正的判断标准是:如果知识库回答的问题80%以上是通用FAQ,SaaS更省;如果一半以上要查玩家账号、订单、封禁记录,自建才划算。
怎么落地:从一台机器到一条流水线
可执行的最小路径:第一步,整理文档,把FAQ、公告、申诉模板按主题切成300~500字的块,加元数据(版本、生效日期);第二步,用Ollama或vLLM部署7B指令模型,Embedding模型单独跑;第三步,接一个轻量检索层,玩家提问先向量召回Top3~5文档块,再拼进提示词;第四步,留人工接管入口,回答置信度低时转工单。避坑要点:不要一上来就上14B+长上下文,显存和延迟都会翻倍;不要把后台数据库直接暴露给模型,用只读视图;模型权重和玩家数据尽量放在同一地区,跨境传输要评估合规。
选购推荐
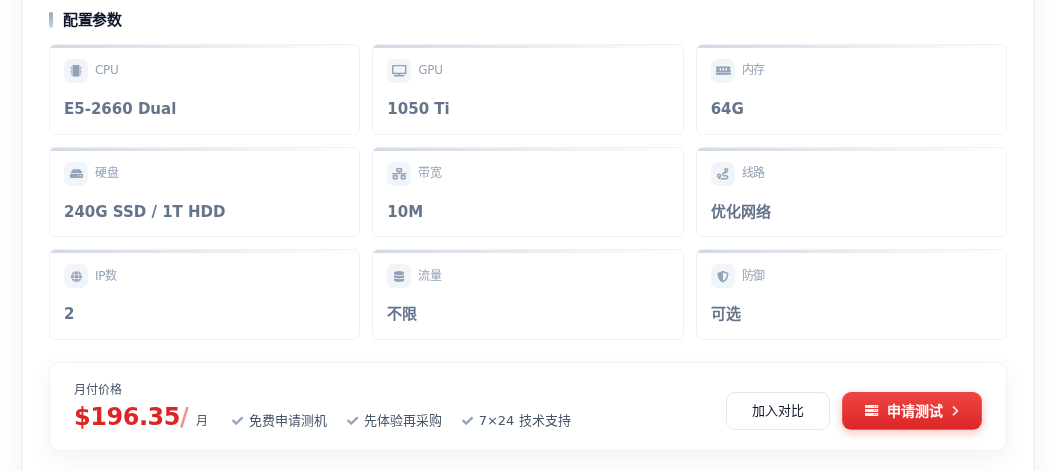
如果团队刚起步,只想验证RAG问答效果,香港显卡物理服务器2*E5-2660(1050 Ti)是更稳的起点:64G内存、240G SSD加1T HDD,1050 Ti的4GB显存跑7B INT4和Embedding模型足够,196.35元/月的量级对私服团队压力很小,香港机房对内地玩家延迟也相对友好。若后续要跑14B量化模型或更高并发,可考虑硅谷GPU服务器 IV,1080显卡、双E5-2680、32GB内存、100M带宽,748元/月,适合把知识库和游戏后台工单系统放在同一台机器上做联调。两台都不是训练卡,定位就是推理和验证,别指望拿它们微调模型。
决策建议:先用SaaS或一台入门GPU物理机跑两周试点,统计人工接管率;接管率低于20%且问题以通用FAQ为主,继续用SaaS或低配物理机即可;接管率高于40%、大量问题要查账号和订单,再考虑升级到14B模型和更高显存的机器。显存不是越大越好,能覆盖真实并发和召回质量的那一档,就是最省钱的那一档。