DeepSeek私有化部署落地指南:跨境卖家从4张卡到30并发的回本测算
一个做亚马逊美国站与独立站的女装卖家,日订单约3000单,客服团队8人,旺季时每天要回复2000多条售前咨询与售后工单。客服外包加人工成本每月接近6万元,且回复质量不稳定。团队想用DeepSeek做私有化客服+RAG知识库,把退换货政策、尺码表、物流时效喂进去,先承接60%的重复问题。这个案例复盘的就是从4张卡起步到稳定跑30路并发、并算清多久回本的全过程。
第一步:先算显存与并发,再决定买几张卡
私有化部署的第一步不是买机器,而是把模型规模和并发量锁死。跨境客服场景一般不需要满血大模型,DeepSeek-R1-Distill或7B~14B量级的模型在中文问答与工单分类上已经够用,量化到INT8或INT4后,单卡显存占用大致如下:7B模型约8~12GB,14B模型约16~24GB,32B模型约40GB以上。这决定了一张卡能不能放下。
并发不是靠猜的。经验估算法是:单路对话的上下文约2K~4K token,客服场景首字延迟控制在1.5秒以内体验较好;一张24GB显存的卡跑7B量化模型,通常能撑8~15路中等并发,14B模型则降到4~8路。按日咨询2000条、高峰集中在晚间4小时估算,峰值并发约25~35路。结论是起步配2~4张24GB级显卡,先跑7B+14B双模型,把RAG检索和重排放在CPU侧。
第二步:机器怎么配,云GPU还是物理机
这个团队先试了两周云GPU按量计费,跑通RAG链路和提示词,确认效果后才决定上物理机。云GPU适合验证期,按小时计费灵活,但长期跑推理的月度成本会明显高于物理机,且数据要出境,对涉及客户订单信息的客服场景需要额外评估合规。物理机的优势是数据留在本地、成本可摊薄、带宽和IP可控。
选购时要对比的参数清单:显存容量与卡数(决定能跑多大模型、多少并发)、GPU型号与算力(推理看显存带宽和FP16/INT8性能)、CPU核数与内存(RAG向量检索、文档解析吃CPU和内存,建议内存不低于显存的2倍)、系统盘与数据盘(模型文件动辄十几GB,SSD是刚需)、带宽与流量(客服系统面向海外买家,出口带宽和线路质量直接影响首字延迟)、地区与合规(香港、新加坡适合亚太与东南亚业务,美国节点贴近北美买家,欧洲需考虑GDPR)。
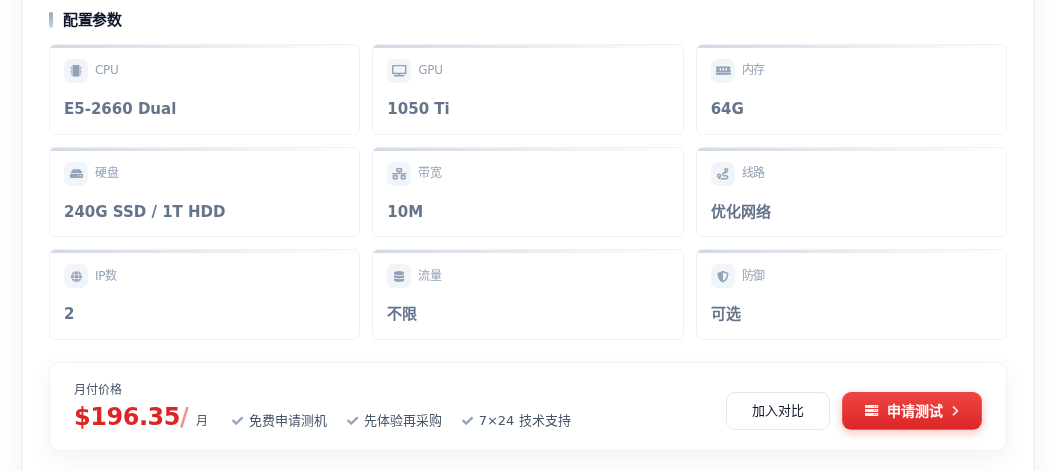
起步阶段的现实选择是先用入门级GPU物理机跑通链路和小流量灰度,再按并发增长加卡。例如香港显卡物理服务器2*E5-2660(1050 Ti),64G内存、240G SSD加1T HDD、10M带宽,196.35元/月,适合把RAG知识库、工单分类和7B量化模型的小流量推理先跑起来,香港节点对东南亚与国内团队的访问延迟都比较友好。等并发稳定超过15路,再升级到多卡机型或拆分推理与检索服务。
第三步:回本测算与踩坑清单
回本账要算三块:省下的人力、减少的退款与差评损失、增量转化。以案例中的卖家为例,客服人力与外采合计每月约6万元,私有化上线后承接60%重复咨询,理论上可释放3~4人,月省2万~2.5万元;响应速度从平均4小时降到1分钟内,退货纠纷率下降带来的损失减少约每月3000~8000元。机器与电费、运维投入按月几千元量级计,通常3~6个月可以覆盖投入。真正的变量是并发上限——如果模型选得过大、单卡只能跑3路,回本周期会被拉长一倍。
实操踩坑清单:一是别用满血大模型起步,7B~14B量化版足够客服场景,显存省下来换并发;二是先做RAG再做微调,知识库更新频繁,微调成本高且容易过时;三是首字延迟要实测,用真实咨询日志压测,别只看吞吐;四是带宽别省,海外买家访问慢会直接反映在转化上;五是数据合规先确认,订单与客户信息涉及出境时优先选香港、新加坡等节点并做脱敏;六是留好降级方案,模型服务挂了要能切回人工或小模型兜底。
选购推荐
对刚起步、想低成本验证链路的跨境团队,优先考虑香港或硅谷的入门GPU物理机:贴近目标市场、带宽够用、月付压力小。上文提到的香港1050 Ti机型适合亚太与东南亚业务的小流量灰度;如果买家主要在美国,硅谷GPU服务器 II配1050显卡、双E5-2620、32GB内存、1T SSD与100M带宽,199元/月,出口带宽更宽,适合独立站客服与AI素材生成的初期验证。两款都建议先跑7B量化模型加RAG,压测出真实并发上限后再决定加卡或换多卡机型。
决策建议总结:跨境卖家做DeepSeek私有化,起步不要追求大模型和大卡数,先用入门GPU物理机把RAG链路和7B~14B量化模型跑通,实测首字延迟与并发上限;当月咨询量稳定超过2000条、峰值并发接近20路时,再按显存缺口加卡。回本的关键不在机器多贵,而在模型规模与并发是否匹配真实业务量。