怎样给AI客服选显存:从0到1的落地配置与避坑清单
客服机器人从「关键词匹配」换成大模型之后,第一个卡住中小团队的问题往往不是模型效果,而是:客服会话一进来就排队,首字延迟从 1 秒飙到 5 秒以上,用户直接关掉窗口。多数情况不是模型不行,而是显存和并发没算过账——显存不够就装不下 KV Cache,并发一高就只能排队,首字延迟自然崩。下面按落地顺序拆成几个坑点,给出可直接对照的判断标准。
坑一:只看模型参数量,不算 KV Cache 和并发
显存占用大致由三块构成:模型权重、KV Cache、框架与运行时开销。以 7B~8B 模型为例,FP16 权重约 14~16GB;INT8 约 7~8GB;4bit 量化约 4~5GB。但真正决定「能扛多少并发」的是 KV Cache:它随上下文长度和并发数线性增长,长上下文客服场景(把历史对话和知识库片段塞进 prompt)尤其吃显存。
- 判断标准:先定「单次上下文长度」和「峰值并发」。常见客服 RAG 场景单请求上下文在 2K~8K token,若按 4K 估算,7B 模型在 FP16 下每路并发约需 0.5~1GB KV Cache,量化后可降到 0.2~0.4GB 量级,具体视框架与服务商实现而定。
- 落地做法:用 vLLM、TGI 或 Ollama 这类推理框架先做压测,记录不同并发下的首字延迟(TTFT)和每秒输出 token 数,再反推显存余量。
- 常见误区:把「模型能加载」当成「能对外服务」。加载成功只是起点,留 20%~30% 显存给 KV Cache 和碎片才稳。
坑二:显存档位与并发量级不匹配
按中小企业客服的典型规模,可参考以下量级(均为经验区间,实际以压测为准):
- 8~16GB 显存:跑 7B 量化模型,适合 3~10 路并发、内部试用或低频客服,首字延迟通常 1~3 秒。
- 24GB 显存(如 3090/4090 级):7B~14B 量化模型的主力档,可支撑 10~30 路并发,是多数中小团队自建客服的性价比区间。
- 48GB 及以上(A6000、L40S、A100 等):14B~32B 模型或更高并发,适合多业务线共用、需要长上下文与 RAG 重排的场景。
- 多卡:当单卡显存不够装权重加 KV Cache 时再考虑,注意张量并行会带来卡间通信开销,首字延迟不一定线性改善。
这里要提醒:客服是「短请求、高并发」型负载,跟批量离线推理完全不同。宁可显存留余量,也不要把并发压到极限,否则尾延迟会非常难看。
坑三:地区、带宽与合规没提前定
AI 客服常连着企业知识库和客户对话数据,数据出境与合规要先想清楚。面向国内用户的客服,通常优先选香港或内地节点,香港机房对大陆访问延迟较低、国际带宽灵活;面向欧美或东南亚客户,硅谷、新加坡节点更合适。判断标准有三条:
- 数据是否需要留在境内:涉及个人信息与业务敏感数据时,先确认部署地的合规要求,再决定机房位置。
- 带宽是否够用:推理请求本身流量不大,但知识库同步、日志回传、模型下载会吃带宽,10M 与 100M 的差别在模型拉取阶段非常明显。
- 是否要公网高防:客服入口暴露在公网,被刷接口是常态,需要评估基础防护与限流策略。
实操上建议先用一台 GPU 机器跑通模型、RAG 检索和压测,再按压测结果扩容,而不是一上来就买大卡。
坑四:只看显卡型号,不看整机与售后
选购时建议逐项对比:显卡型号与显存容量、CPU 核数与内存(RAG 检索和向量库很吃内存,建议 32GB 起步、64GB 更稳)、系统盘与数据盘、带宽与流量计费方式、是否支持独立 IP、能否按月付费试跑、故障响应时效。对中小团队来说,「能按月试、能快速换机」比单看跑分更重要。
选购推荐
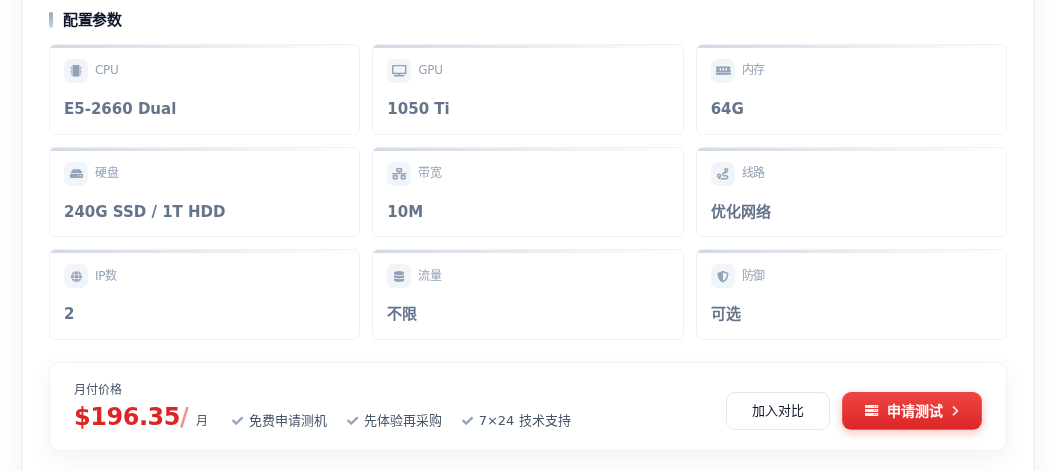
如果目标是先低成本验证 AI 客服链路(7B 量化模型 + 小规模并发 + 压测),可以从入门级 GPU 机器起步,跑通后再升级:香港显卡物理服务器2*E5-2660(1050 Ti),64G 内存对向量库和检索服务比较友好,香港节点对大陆访问延迟相对可控,月付 196.35 元起,适合做验证环境。若面向海外客户、需要更大带宽拉取模型与同步知识库,可考虑 硅谷GPU服务器 III,AMD WX 7100 显卡、64GB 内存、100M 带宽,月付 579 元,适合作为小团队正式对外服务的第一台推理机。需要说明的是,这类入门卡更适合 7B 量化模型与低并发场景,若要跑 14B 以上或数十路并发,仍需按上文量级升级到 24GB 及以上显存。
决策建议:先用压测确定「上下文长度 × 峰值并发」对应的显存需求,再按 24GB 作为中小客服的主力档位规划;预算有限时用入门 GPU 机器验证链路,确认效果与延迟达标后再扩容。机房选择以数据合规和用户分布为准,带宽按模型拉取与知识库同步的实际需求留余量。