DeepSeek带火私有化RAG后,站群团队自建客服知识库要多大显存才够
热点变了:DeepSeek 蒸馏版让站群团队也敢自建 RAG
过去一年,矩阵站群团队对「自建知识库」的态度很一致:想用,但算不起。原因很直接——早期动辄 70B 参数的模型,推理至少要 2 张 80G 卡起步,中小团队根本接不住。DeepSeek 蒸馏系列、Qwen 7B/14B、Llama 3.1 8B 这类中小尺寸模型成熟之后,局面变了:一台带单张消费级或专业卡的物理机,就能跑起一个够用的 RAG 客服问答服务。
站群团队的典型需求也很特殊:不是给百万用户做通用客服,而是给几十上百个站点配「能读自己站内文章、能回答产品与政策问题、能引导留资」的问答入口。并发不高,但站点多、知识库分散、内容更新频繁。这类负载决定了显存不需要堆到顶,但要算清楚「峰值同时几个会话」这个数。
显存测算:先算并发,再谈卡
RAG 推理的显存占用分两块:模型权重和KV Cache(上下文缓存)。权重部分按参数量和量化精度估:7B/8B 模型 FP16 约需 14~16GB,INT8 约 8GB,4bit 量化可压到 5~6GB;14B 模型 FP16 约 28GB,4bit 约 10GB。KV Cache 则随并发数和上下文长度线性增长,一般 7B 模型、4K 上下文、单路会话约占 0.5~1GB。
据此可以给出一个判断标准:
- 单站低频问答(同时 1~3 路会话):8B 模型 4bit 量化,8GB 显存可用,12GB 更稳。
- 多站共用一套知识库(同时 5~10 路):8B FP16 或 14B 4bit,16GB 显存是舒服的起点。
- 带数字人、语音或批量生成素材(同时 10 路以上,且要跑 embedding 与 rerank):24GB 显存起步,或拆成推理机 + 向量检索机两台。
三条落地路线横评:云 GPU、消费卡物理机、专业卡物理机
路线一:云 GPU 按量付费
优点是不用一次性投入、随时换卡;缺点是长期跑推理成本高,且数据出境与合规要单独确认。适合验证期和流量波动大的团队。月成本量级通常在数百到数千元,视卡型与时长而定。
路线二:消费级显卡物理机
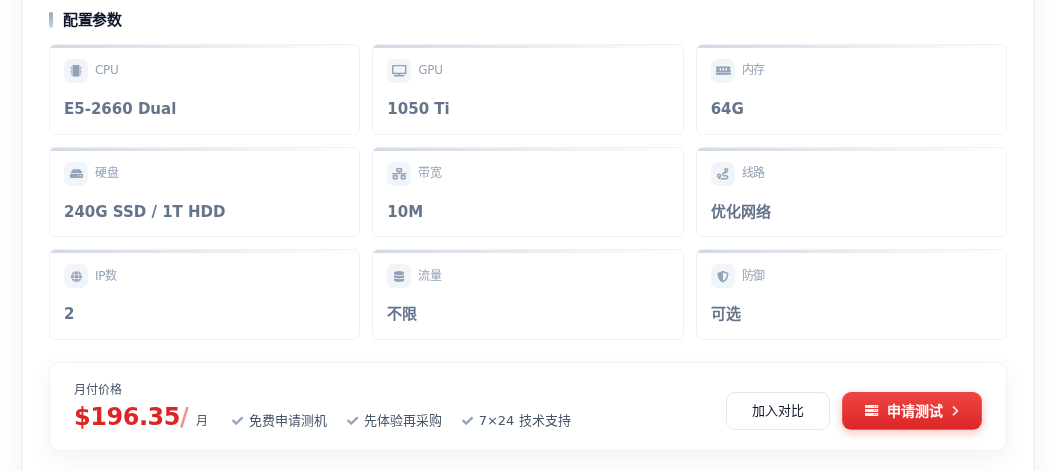
站群团队最常见的选择。GTX 1050 Ti、1080 这类卡显存 4~8GB,适合跑 7B/8B 量化模型做单站或小并发问答;缺点是显存偏小、不能跑大模型,且多为二手卡,稳定性视服务商而定。优势是价格门槛低,月付百元级到数百元级即可起步,适合先把 RAG 流程跑通。
路线三:专业卡或大显存物理机
AMD WX 7100 这类 8GB 专业卡、或 24GB 以上显存的机型,适合同时挂多个站点知识库、跑 embedding 与 rerank 的团队。价格量级在数百元至千元级每月,比云 GPU 长期更划算,但需要自己承担运维。
选型时要对比的参数清单:显存容量与位宽、是否支持目标量化格式、CPU 核数与内存(RAG 检索吃内存)、SSD 容量(向量库与文档存储)、带宽与月流量、机房地区(数据是否需留在境内或近岸)、是否支持独享 IP 与高防。站群团队尤其要关注带宽——知识库文档上传和向量重建是持续动作,10M 带宽做小规模够用,站点多则要往上加。
选购推荐
如果目标是先把 RAG 客服跑通、单站或少量站点并发,香港显卡物理服务器2*E5-2660(1050 Ti)是较稳妥的起点:1050 Ti 的 4GB 显存配合 64G 内存,跑 8B 模型的 4bit 量化、同时接 3~5 路会话基本够用,双路 E5 与 64G 内存对向量检索和文档处理也友好,香港机房对面向东南亚与国内访问的站点延迟较均衡。
如果知识库规模更大、要同时挂多个站点并保留跑 embedding 与 rerank 的余量,硅谷GPU服务器 III(AMD WX 7100 / 双路 E5-2683v4 / 64GB)更合适:8GB 专业卡显存比消费卡宽裕,100M 带宽对批量上传文档和素材生成更从容,适合把 RAG 客服与 AI 投流素材生成放在同一台机器上错峰跑。
决策建议
站群团队自建 RAG 客服,不必一上来就追大显存。先用 8GB 级显存把「文档切分—向量化—检索—生成」全链路跑通,测出真实并发与首字延迟,再决定是否升级到 16GB 或 24GB。显存按「峰值并发 × 单路缓存 + 模型权重」估算,留 20%~30% 余量即可;带宽、内存和 SSD 往往比多出的几 GB 显存更早成为瓶颈。