中小企业自建RAG知识库:显存与并发测算的五个坑,你踩了几个?
坑一:显存只算模型大小,忽略KV Cache和并发余量
很多卖家在选AI服务器时,只盯着模型文件大小:7B模型约14GB(FP16),量化后4-6GB,觉得一张8GB显存的卡就够。但实际跑RAG推理时,显存占用远不止模型本身。以Llama 3 8B或Qwen2 7B为例,FP16下权重约16GB,加上KV Cache(与并发数、上下文长度强相关)、推理框架开销、Embedding模型和Reranker模型,一张24GB卡(如RTX 3090/4090)通常只能稳定支撑3-5个并发请求(上下文2K以内)。如果上下文拉到8K,并发数直接腰斩。避坑方法:显存需求 = 模型权重 + KV Cache(并发数×上下文长度×层数×2×精度) + 框架预留(约2-4GB)。简单估算:7B模型FP16、4K上下文、5并发,建议至少24GB显存;13B模型建议48GB起步;若用INT8量化可适当降低,但精度损失需实测。别信“一张卡跑全公司知识库”的说法,那是单用户演示,不是生产环境。
坑二:并发承接量拍脑袋,没考虑首字延迟和RAG链路开销
RAG不是单纯的大模型对话,链路包括:用户提问→Embedding向量化→向量库检索→拼接Prompt→大模型生成→返回。其中Embedding和向量检索通常很快(毫秒级),但大模型生成的首字延迟(TTFT)和每秒输出token数(TPS)才是并发瓶颈。以7B模型在单张24GB卡上为例,FP16精度下,TPS大约20-40 tokens/s(视框架优化),首字延迟约0.5-1.5秒。若要求每个用户感觉“秒回”,并发数超过5-8个就会明显排队。避坑方法:先明确业务场景——客服知识库通常允许2-3秒首字延迟,可适当超卖;内部文档问答要求更高。建议用vLLM或TGI框架实测,记录不同并发下的P95延迟。一般中小企业初期按5-10并发规划即可,预留1.5倍余量。别直接按“员工数=并发数”算,实际同时提问的人通常不到10%。
坑三:只比GPU单价,忽略带宽、存储和运维隐性成本
自建RAG知识库的成本账要拆开算:GPU服务器租金(云GPU按小时或包月,物理机包月)、带宽费用(知识库文档上传、用户访问、模型下载都吃带宽,香港/新加坡机房国际带宽贵,美国硅谷相对便宜)、存储(向量库和原始文档,SSD需求看数据量)、运维人力(部署、监控、更新模型)。以跨境电商场景为例,知识库包含产品手册、售后政策、物流模板,文档量几十GB,向量库几GB,存储压力不大,但带宽要支撑国内运营团队和海外客服同时访问。若选香港机房,10M带宽月费通常几百元,但延迟对国内用户友好;若选美国硅谷,100M带宽月费可能更低,但国内访问延迟高,适合主要面向海外用户的场景。避坑方法:先列出所有成本项,按月折算,对比“云GPU按需”和“物理机包月”的盈亏平衡点。一般日请求量低于5000次,云GPU更灵活;高于则物理机更划算。别只看GPU月租,把带宽和存储加进去再比。
坑四:忽略数据合规与地区选择,知识库“出海”变“出险”
跨境电商卖家的知识库常包含客户数据、订单信息、产品配方等敏感内容。若把知识库部署在境外机房,需考虑数据出境合规(如中国《个人信息保护法》、欧盟GDPR)。一般建议:面向国内用户的客服知识库,优先选香港机房(数据不出境,延迟低);面向欧美用户,可选美国硅谷或欧洲机房,但需确认服务商的合规资质。避坑方法:先明确知识库中是否含个人数据,若含,评估是否需要本地化部署;若纯产品文档,地区选择更自由。另外,香港机房国际带宽充足但价格较高,美国硅谷带宽便宜但国内访问慢,新加坡机房对东南亚用户友好。根据用户分布选地区,别为了省租金把知识库放在离用户太远的地方。
选购推荐:小成本起步,选对机型少花冤枉钱
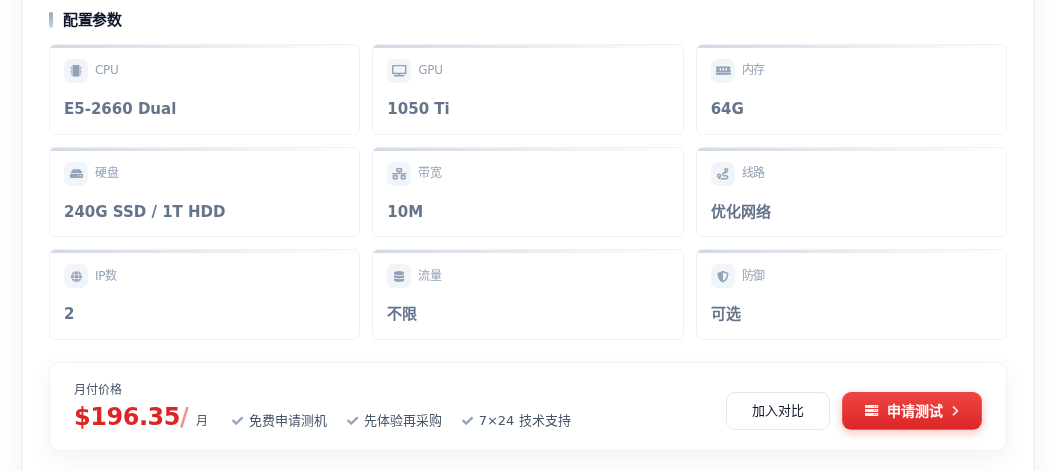
对于刚起步的跨境电商团队,建议先用低成本GPU物理机验证RAG链路和并发表现,再决定是否升级。秀米云有两款机型适合不同阶段:香港显卡物理服务器2*E5-2660 (1050 Ti),配置GPU 1050 Ti / 双路E5-2660 / 64G内存 / 240G SSD+1T HDD / 10M带宽,月费196.35元,适合知识库文档量不大、并发5人以内的场景,香港机房对国内运营团队延迟友好,GTX 1050 Ti 4GB显存可跑量化后的7B模型(INT4),做初步验证足够。若主要面向海外用户且需要更高带宽,可考虑硅谷GPU服务器 III,配置GPU AMD WX 7100 / 双路E5-2683v4 / 64GB内存 / 1T SSD / 100M带宽,月费579元,100M带宽适合海外客服并发访问,WX 7100 8GB显存可支撑量化7B模型或小参数模型,性价比不错。两款都建议先跑vLLM实测并发和首字延迟,再按需扩容。链接:香港显卡物理服务器2*E5-2660 (1050 Ti)、硅谷GPU服务器 III。
决策总结
自建RAG知识库不是拼显卡参数,而是算清显存、并发、带宽、合规四笔账。建议先用低成本物理机(如上述香港1050 Ti机型)验证业务链路,用vLLM实测5-10并发下的延迟表现,再根据日请求量决定是否升级到更高显存或更多卡。记住:显存留余量、并发看延迟、成本算全包、地区跟用户走。避开这四个坑,中小企业也能用可控预算跑起自己的知识库。