矩阵站群自建AI内容中台:DeepSeek本地部署选7B还是32B,配什么机器才
一个做矩阵站群的团队,手上跑着两百多个内容站,日常要产出标题、摘要、长文初稿和批量改写。早期全靠公有云API,单篇成本可控,但站群放量后问题集中爆发:高峰期限流排队,批量任务经常卡在夜间;多站点共用一套提示词模板,调用量一大账单就跳;更麻烦的是站群里沉淀的关键词库和行业语料,团队不希望长期外发。于是决定把 DeepSeek 蒸馏版模型私有化部署,自建一套内容中台。这篇文章复盘的就是那次选型的账本:7B 还是 32B、云 GPU 还是物理机、并发与首字延迟到底怎么估。
第一步:显存账先算清楚,再谈机器
私有化部署的第一笔账不是价格,是显存。通用估算方式是:参数量 × 每参数字节数 × 1.2~1.5 的冗余系数。以 FP16 为例,7B 模型权重约 14GB,加上 KV Cache 与推理框架开销,单卡 24GB 勉强可跑但并发很浅;32B 模型 FP16 权重要 64GB 上下,通常需要 80GB 级显卡或双卡。真正让中小企业跑得动的是量化:INT8 大致把权重压到一半,INT4 再压一半,代价是长文本生成质量有轻微下降。
这个团队的实测结论是:7B/8B 的 INT4 量化版,16GB 显存即可启动,24GB 显存能撑起小并发;32B 的 INT4 量化版,单卡 24GB 吃紧,48GB 以上更稳。站群场景的文本以千字级为主,7B 量化版在改写、扩写、标题生成上够用,事实性强的长文仍建议走更大模型或人工复核。选型时先确定「最重的那个任务」,再倒推显存,不要先买卡再想模型。
第二步:并发与首字延迟,用真实业务量去测
很多团队买完机器才发现,标称能跑不等于能扛业务。首字延迟(TTFT)主要受预填充阶段影响,和输入长度强相关;吐字速度则取决于显存带宽与批处理策略。经验量级是:7B 量化模型在 24GB 卡上,短输入首字延迟通常在数百毫秒到 1 秒多,长上下文(8K 以上)会明显拉长;32B 模型同条件下首字延迟往往翻倍。
并发方面,站群的真实压力是「批处理」而非「实时对话」——夜里跑几千篇初稿,白天少量人工微调。这类负载更适合用队列把请求串起来,牺牲总时长换稳定。团队的做法是:先用 20~50 并发做压测,记录 P95 首字延迟和每分钟出字数,再对照内容排期反推需要几台机器。判断标准可以简化为三条:单机每分钟能否产出满足当日排期的字数;P95 首字延迟是否在可接受范围;显存占用是否长期低于 85%。任何一条不达标,就该考虑加机器或降模型规格。
第三步:云 GPU、物理机还是多 IP 小机器
三条路各有适用场景。云 GPU 按小时计费,适合验证期和流量波动大的阶段,但长期满载跑下来月成本通常高于物理机;物理显卡服务器月付固定,适合负载稳定、要长期在线的内容中台;多 IP 小机器则适合把「模型推理」和「站点分发、采集」拆开部署,避免互相抢占资源。
地区差异也要算进去。香港机房到内地延迟低、走 CN2 或 BGP 线路体验好,适合需要人工实时微调的团队;美国硅谷带宽给得足、单价更低,适合纯离线批处理任务;日本、新加坡节点则在面向东南亚站点时更顺手。合规上,站群语料若含用户数据,优先选数据不出境或可控的部署位置,别等出问题再迁移。踩坑点集中在两处:一是只盯显卡型号不看整机带宽与硬盘 IO,批量读写语料时 SSD 和带宽先成瓶颈;二是低估散热与电源,长期满载的物理机要确认机房供电与散热余量。
选购推荐
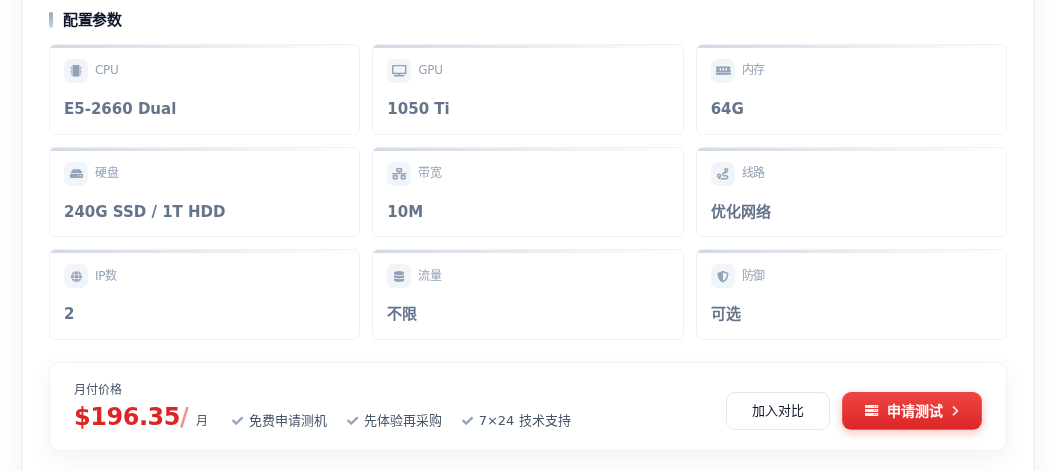
结合上面的账本,验证期或小规模批处理,可以从入门级显卡物理机起步,把模型控制在 7B 量化版、并发压在低位,先跑通内容流水线再扩容。秀米云在售机型中,香港显卡物理服务器2*E5-2660(1050 Ti)配 64G 内存与 240G SSD + 1T HDD,月付 196.35 元,香港线路对内地访问友好,适合需要白天人工微调、夜间跑批量改写的站群团队;若负载以纯离线生成、对延迟不敏感,硅谷GPU服务器 IV提供 1080 显卡、双路 E5-2680 与 100M 带宽,月付 748 元,带宽余量更适合大规模语料同步与成品分发。需要提醒的是,这两类配置跑 32B 模型都会吃紧,定位应是 7B 量化版的推理与内容流水线,而不是替代高显存推理卡。
决策建议
站群团队自建 DeepSeek 内容中台,先按「最重任务定显存、真实排期定并发、负载形态定云或物理机」三步走:7B 量化版配 16~24GB 显存起步,32B 量化版预留 48GB 以上;首字延迟以 P95 压测为准,不要信标称值;负载稳定的长期任务优先物理机,验证期用云 GPU。机器只是下限,队列调度、提示词模板和人工复核流程才是决定内容质量的上限。