RAG 客服要多大显存才够?中小团队自建选显卡服务器还是云 GPU
客服机器人从「关键词+FAQ」升级到 RAG(检索增强生成)之后,最先卡住中小团队的不是模型选型,而是显存:知识库文档几千份、日咨询几百到几千条,到底要不要上 24G 卡?两张卡够不够?云 GPU 按小时计费和买物理机哪个更划算?这类问题没有标准答案,但有一套可以照着算的判断标准。
先算显存:按并发和上下文倒推,而不是按参数量拍脑袋
RAG 客服的推理成本主要来自三块:模型权重、KV Cache(缓存对话上下文)、检索侧的向量模型。常见组合是 7B~14B 的对话模型(Qwen、Llama 系列)配一个小的 embedding 模型,再加向量库。判断标准如下:
- 7B/8B 模型 FP16:权重约 14~16GB,单张 24G 卡可以放下,但留给 KV Cache 的空间只剩几 GB,长上下文(比如把整段知识库片段塞进 prompt)时并发会迅速掉到个位数。
- 7B/8B 模型 INT8 或 AWQ/GPTQ 4bit 量化:权重降到 4~8GB,24G 卡能比较从容地支撑十几路到几十路并发,首字延迟也能压在 1~2 秒量级,这是中小企业自建客服最主流的落点。
- 14B 级别:FP16 需要 28GB 以上,通常要 2×24G 或单张 48G;量化后单张 24G 勉强可用,但并发余量小,适合咨询量不大、对回答质量要求高的场景。
- 32B 及以上:一般不建议中小团队自建,除非有明确的数据不出境或行业合规要求,否则云 API 或租用整机更省心。
实操上更可靠的做法是:先用目标模型在测试机上跑一轮压测,记录「并发 5 / 10 / 20 时的首字延迟和显存占用」,再乘以 1.5 倍安全系数决定采购规格。客服场景对首字延迟敏感(用户等 3 秒以上就会重复提问),但对总吞吐要求不算高,所以显存优先于算力。
云 GPU 还是物理机:什么规模该换机器
这是中小团队最容易纠结的一步。按市场行情量级判断:
- 日咨询量 200 条以内、只有白天高峰:云 GPU 按量计费或抢占式实例更划算,随开随停,不用养运维。
- 日咨询量稳定在几百到几千条、需要 7×24 在线:云 GPU 月账单通常会超过一台中端显卡物理机的价格,这时自建或租用物理机更划算,也更可控。
- 有数据合规要求(客户资料、订单信息不能出境):优先考虑香港、新加坡等近岸机房,既能满足数据存放地要求,又能兼顾内地访问延迟;纯内地业务则选内地机房,但 GPU 机型供给和价格波动更大。
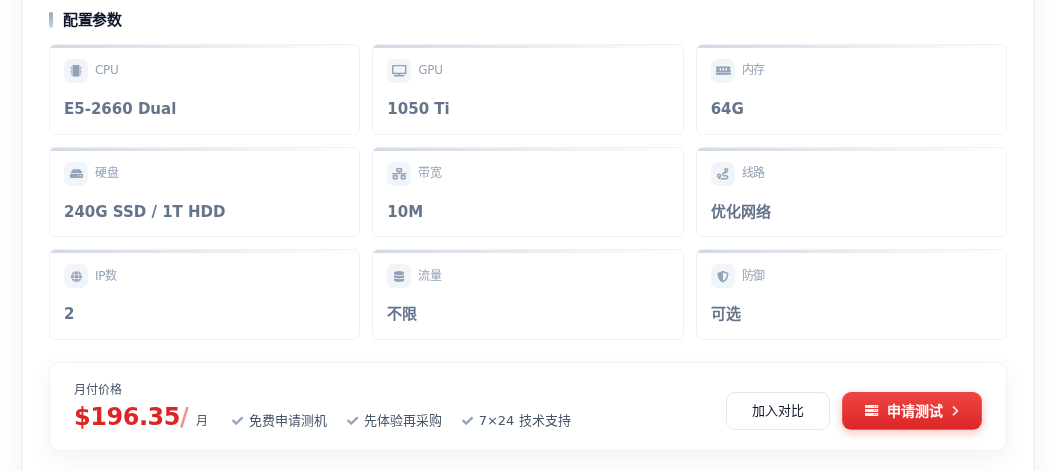
需要提醒的是,很多低价「GPU 服务器」用的是 GT740、1050 Ti 这类老卡,显存只有 4GB,跑 7B 量化模型都会 OOM,只适合做向量检索、OCR、轻量图像处理或开发测试,不能当作 RAG 客服主力机。选购时务必确认:显存容量、是否支持 FP16/INT8、CUDA 版本、内存与 SSD 是否够放知识库和向量索引、带宽是否够拉模型权重(几十 GB 的权重文件,10M 带宽下载要按小时算)。
选购对比清单与常见坑
给运维/开发者一份可以直接拿去比价的参数清单:
- 显存:RAG 客服主力机建议 24G 起步;仅做 embedding 与测试可用 8G~16G。
- 内存:不低于显存的 2 倍,加载模型和向量库时不会被 OOM Killer 干掉。
- 存储:系统盘 SSD + 数据盘,知识库原文、向量索引、日志分开存放。
- 带宽与线路:模型权重首次拉取、知识库增量同步都吃带宽;面向内地用户时关注是否 CN2/优化线路,面向海外用户看国际带宽。
- 计费方式:月付物理机 vs 按小时云 GPU,按实际在线时长折算月成本再比较。
- 合规:数据存放地、是否允许跨境传输、是否需要备案,提前和业务方对齐。
常见坑包括:只看参数量不看量化方式,买回来发现并发上不去;忽略上下文长度,RAG 拼接的 prompt 越长 KV Cache 越吃显存;用低带宽机器拉权重导致部署拖一整天;以及把开发测试机和生产机混用,压测数据失真。
选购推荐
如果现阶段只是验证 RAG 链路、做 embedding 与轻量推理,预算敏感,可以先用 香港显卡物理服务器 2*E5-2660(1050 Ti)(196.35 元/月)跑通检索、切分、召回流程,香港机房对内地访问延迟相对友好,适合把知识库和客服前端先搭起来。
如果已经进入小规模生产、需要 7B 量化模型稳定支撑日常并发,且希望带宽充裕、方便拉取模型权重,硅谷 GPU 服务器 IV(GTX 1080)(748 元/月,100M 带宽)更适合作为过渡主力机:显存和算力足以跑 7B 量化模型的中低并发推理,100M 带宽在部署和知识库同步阶段能省下大量等待时间。若后续并发继续上涨,再考虑升级到 24G 显存级别的机型或拆分推理与检索服务。
决策建议:先用云 GPU 或低配物理机压测出自己业务的真实并发与显存曲线,再按「日咨询量 × 首字延迟要求」锁定机型;显存按 24G 规划、带宽按 100M 规划,是当前中小团队自建 RAG 客服比较稳妥的起点。