DeepSeek/Qwen私有化部署要花多少钱:显存、并发、首字延迟三项成本账怎
先算清三笔账:显存决定机器价,并发决定卡数,延迟决定线路
外贸企业做私有化部署,典型场景是给业务员配一个懂产品手册、报价单、历史邮件的 AI 客服或 RAG 知识库,要求客户资料和询盘数据不出境。真正决定预算的不是「能不能跑起来」,而是三个可以量化的指标:模型权重占多少显存、同时有多少人在用、第一个字多久出来。
- 显存账:参数量按精度折算,FP16 每 10 亿参数约 2GB,INT8 约 1GB,INT4 约 0.5GB,再叠加 KV Cache 与推理框架开销,通常要预留 20%~30% 余量。7B 模型 INT4 量化后 4GB 左右能跑,但加上上下文缓存和并发,实际按 8GB~12GB 显存规划更稳;14B 建议 16GB~24GB;32B 建议 24GB~48GB;70B 级别基本要 48GB 以上甚至多卡。
- 并发账:并发不是「注册人数」,而是同一秒内正在生成的人数。经验值:单张 24GB 卡跑 7B~14B 的 INT4 推理,稳定支撑 5~15 路并发;32B 级别单卡往往只能 2~5 路。业务高峰按「在线人数 × 10%~20%」估并发,再乘 1.5 倍安全系数。
- 延迟账:首字延迟由预填充算力、模型大小、上下文长度共同决定,通常 7B 在消费级 GPU 上首字 0.3~1 秒,32B 在 1~3 秒;上下文从 4K 拉到 32K,首字延迟可能翻倍。网络侧,跨境访问境外机房会增加 100~300ms 的 RTT,这部分是线路成本,不是算力成本。
坑点清单:这七种情形最容易多花钱
坑一:只按参数量买卡。判断标准:拿真实业务问题做压测,看 P95 首字延迟和吞吐,而不是看模型能不能加载。加载成功只说明显存够,不代表能扛并发。
坑二:把消费级显卡当生产卡。GTX 系列、GT740 这类卡适合做轻量推理验证、图像预处理、小模型试跑,不适合跑 32B 以上模型。判断标准:看显存容量和是否支持 FP16/INT8 加速,4GB 显存只适合 1B~3B 小模型或做前端服务。
坑三:忽略 KV Cache 随上下文膨胀。同样 7B 模型,4K 上下文和 32K 上下文对显存的占用差距明显。判断标准:把知识库切片长度和检索返回条数定下来再选卡,不要先买卡再定方案。
坑四:低估带宽。10M 带宽的物理机做内部知识库够用,但要做对外 AI 客服、数字人视频或批量生成投流素材,10M 会先成为瓶颈。判断标准:按「并发数 × 单路峰值带宽」估,文本问答单路几十 KB 级,图像与视频生成要高一个量级。
坑五:数据合规想当然。外贸企业常要求询盘、客户名单不出境。判断标准:模型和向量库放在境内或香港节点,业务系统与数据库同区域部署,跨境只走加密 API,不要图便宜把数据放到远端再回传。
坑六:地区选错导致延迟不可接受。面向东南亚客户,香港、新加坡节点通常比美国西海岸更稳;面向欧美客户,硅谷节点更合适。判断标准:先用目标市场网络实测 RTT,再定机房。
坑七:一次性买重资产。业务量未验证时直接上多卡物理机,闲置成本高。判断标准:先用云 GPU 或入门级 GPU 物理机跑 1~2 个月真实流量,再决定是否扩容。
选购推荐:从试跑到生产的两档配置思路
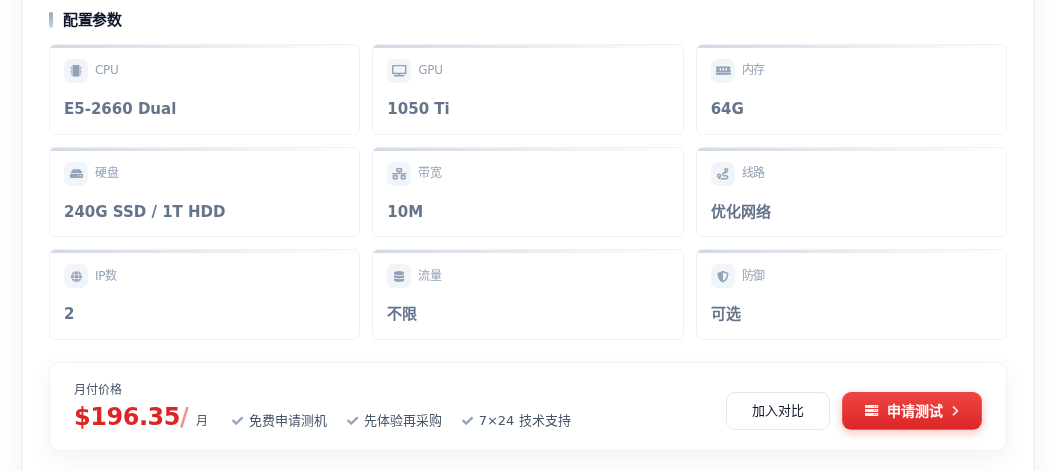
对多数外贸企业,合理路径是「小成本验证 + 按需扩容」。验证阶段跑 7B~14B 量化模型、做 RAG 知识库或 AI 客服原型,重点看显存是否够、首字延迟能否接受、并发上限在哪。这一阶段可以用香港显卡物理服务器2*E5-2660(1050 Ti),64G 内存、GTX 1050 Ti 4G 显存、10M 带宽,196.35 元/月,适合做内部知识库检索、客服意图分类和轻量模型试跑,香港节点对东南亚与国内访问都算友好,客户资料留在香港也便于合规沟通。
如果主要面向欧美客户、需要跑图像预处理或更大一点的模型验证,可看硅谷GPU服务器 IV,GTX 1080 8G 显存、双 E5-2680、32G 内存、100M 带宽,748 元/月,显存和带宽都比入门档宽裕,适合做 7B~14B 量化推理的压测和 AI 素材批量生成的早期验证。需要提醒:这两档都属于验证与轻负载定位,真要上 32B 以上模型或几十路并发,应转向 24GB 显存起步的专业卡方案,并用真实流量压测后再定。
决策建议
先定业务边界:是内部知识库还是对外客服,是文本问答还是图像视频生成,客户主要在哪个区域。再按「模型精度折算显存 + 并发乘安全系数 + 目标市场实测 RTT」三步出配置,最后用入门 GPU 机器跑一个月真实流量,把首字延迟和并发上限测出来再扩容。显存买小了换机成本远高于一开始多留 20% 余量,线路选错了再优化也补不回客户等待的那一秒。