DeepSeek私有化部署实测:联机服主该配多大显存的AI服务器
一位做联机生存服的服主碰到的问题是具体的:玩家在群里问「昨晚存档回滚了吗」「服务器什么时候开新赛季」,管理员一天要回上百条重复消息;想用 DeepSeek 做自动回复和玩法问答,又不敢把玩家聊天记录和后台日志丢到公网 API。于是决定自建推理服务。真正动手才发现,卡不在「装不装得上」,而在显存够不够、几个人同时问会不会卡、第一个字要等多久——这三件事直接决定了每月花多少钱。
一、显存账:模型量化后占多少,留多少余量
私有化推理的第一道门槛是显存。以 DeepSeek 蒸馏系列为例,7B 量级模型在 4bit 量化下权重约 4~5GB,加上 KV Cache 与推理框架开销,单卡 8GB 显存属于「能跑但紧」的档位,16GB 才比较从容;14B 量级 4bit 量化权重约 8~9GB,建议 16GB 起步、24GB 更稳。如果坚持 FP16 精度,显存需求大致翻倍,对中小团队并不划算。
服主要特别注意:显存不是唯一变量。模型加载后框架本身会占用一部分,长上下文(比如把整份玩家守则塞进提示词)会让 KV Cache 线性增长。实测经验是,标称 8GB 的卡跑 7B 量化模型、上下文控制在 4K 以内,勉强可用;一旦要接 RAG 知识库、把检索到的多条文档拼进上下文,8GB 会频繁触发换页,首字延迟从 1 秒级恶化到数秒。
二、并发与首字延迟:玩家不会排队等你
联机服的真实流量很集中:开服公告、赛季更新、故障补偿这几个时间点,群里几十人同时问。首字延迟(TTFT)由预填充阶段决定,和输入长度强相关;输出速度(tokens/s)则决定玩家等完整答案的耐心。7B 量化模型在中端卡上,短问题首字延迟通常在 1 秒上下,14B 会明显拉长。
并发方面,单卡推理框架一般能撑住个位数到十几个并发请求,超过之后请求开始排队,首字延迟成倍上升。这里有个常被忽略的坑:并发不是看总人数,而是看同时在线提问的人数。一个两百人在线的服,峰值同时提问可能只有三五个,配置按峰值而非总人数估算,能省下大量预算。反过来,如果打算做全服公告式广播问答,就得按最坏情况留余量。
三、落地过程:从公网 API 到自建的三步走
- 先小规模验证:用一台入门 GPU 机器跑 7B 量化模型,接入群机器人,只开放「常见问题」场景,观察一周的真实提问量与延迟体感。
- 再定配置:根据峰值并发和上下文长度反推显存与卡型,同时把 RAG 知识库(玩家守则、版本日志、补偿规则)单独做成检索层,避免把长文档全塞进提示词。
- 最后选地区与线路:玩家集中在国内,机房放香港通常延迟更友好;面向海外服或需要规避数据出境争议,硅谷节点更合适。香港机房常见 10M 带宽档位,硅谷节点多为 100M 带宽,前者适合低延迟小流量对话,后者适合素材生成、批量任务这类吃带宽的场景。
踩坑清单:别用消费级卡长时间满载跑推理,散热和稳定性是隐患;别把模型权重放在系统盘,单独挂数据盘;别忽略备案与合规,涉及玩家个人信息的内容尽量留在自有机器内处理。
选购推荐
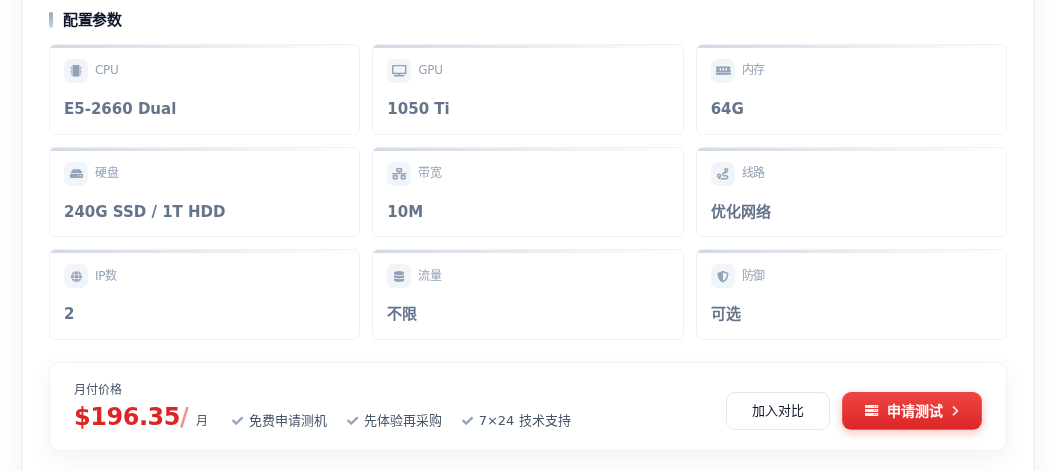
结合联机服主的实际预算,入门验证阶段可以先用 香港显卡物理服务器2*E5-2660(1050 Ti),64G 内存配 1050 Ti,跑 7B 量化模型做群机器人问答足够,香港节点对国内玩家延迟友好,196.35 元/月的量级适合先跑通流程再扩。若后续要做玩法素材生成、批量文本处理,或玩家以海外为主,可以换到 硅谷GPU服务器 II,1050 显卡配双路 E5-2620 与 32GB 内存、100M 带宽,199 元/月,带宽更宽,适合并发稍高、需要拉取外部素材的场景。两款都属于「先验证再升级」的过渡选择,等并发数据和延迟体感稳定后,再考虑加卡或换更高显存机型。
决策建议
联机服主做 DeepSeek 私有化,判断顺序应是:先算峰值同时提问人数,再定上下文长度,最后才看卡型。7B 量化 + 16GB 显存是多数中小服的舒适起点,8GB 只适合验证;首字延迟优先保 1~2 秒体感,超出就减上下文或减并发。地区上,国内玩家为主选香港,海外为主选硅谷,带宽按是否需要批量素材处理来定。先用一台低配机器把流程跑通,比一步到位买高配更省钱。